LLM-Halluzinationen vermeiden: Was in der Praxis wirklich hilft
Halluzinationen in LLMs vermeiden: Abrufgestützte Generierung, Inferenzprüfung, Enthaltungsregeln und Monitoring senken Fehler ohne Modellwechsel.
Kombinieren Sie Retrieval-Augmented Generation, eine NLI-gestützte Begründungsprüfung, klare Enthaltungsregeln und ein sauberes Monitoring. Diese vier Hebel senken die Fehlerquote spürbar, ganz ohne teuren Modellwechsel. Der erste Schritt ist immer der gleiche: Retrieval-Qualität und Antwortverhalten getrennt messen, statt Halluzinationen pauschal dem Modell zuzuschreiben, wie es benchmarked als Strategieberatung zu KI-Adoption und Produktisierung empfiehlt.
Kurz gesagt:
- Die Trennung von Retrieval-Qualität und Antwortverhalten ist entscheidend, um Halluzinationen effektiv zu erkennen und zu reduzieren.
- Ungenaue Retrieval-Daten sind eine häufige Ursache für Fehler, die durch gezieltes Reranking und automatische Quellenprüfung eingeschränkt werden können.
- Multi-Model-Consensus und NLI-gestützte Überprüfung erhöhen die Treue der generierten Aussagen erheblich.
- Automatisiertes Monitoring und menschliches Feedback sind unverzichtbar, um Produktionsfehler frühzeitig zu erkennen und zu beheben.
- Kombinationen aus Retrieval-Augmented Generation, Begründungsprüfung und Enthaltungsmechanismen führen zu den zuverlässigsten KI-Systemen in kritischen Anwendungen.
Was sind LLM-Halluzinationen? Typen und Beispiele
Eine Halluzination liegt vor, wenn ein Sprachmodell eine Aussage produziert, die nicht durch die zugrunde liegenden Fakten oder die bereitgestellten Quellen gedeckt ist. Fachlich unterscheidet man dabei zwei Qualitäten: „Factualness“ beschreibt, ob eine Aussage objektiv wahr ist, „Faithfulness“ beschreibt, ob sie durch den gegebenen Kontext gestützt wird. Ein Modell kann also faktisch richtig liegen und trotzdem nicht treu zur Quelle sein, oder umgekehrt.
In der Praxis begegnen Ihnen vier Muster:
- Faktische Fehler: Das Modell erfindet ein Datum, eine Zahl oder ein Urteil, das es nie gegeben hat.
- Kontextuelle Abweichungen: Die Antwort widerspricht dem eigentlich bereitgestellten Dokument oder ignoriert es.
- Logische Fehler: Die Argumentationskette bricht, etwa bei mehrstufigen Berechnungen oder Schlussfolgerungen.
- Multimodale Diskrepanzen: Bei Bild- oder Tabellendaten beschreibt das Modell Inhalte, die im Original gar nicht vorkommen.
Die Fraunhofer-Forschung zu generativer KI ordnet solche Fehlermuster systematisch ein. Für Ihre Anwendung zählt vor allem eines: In produktiven Systemen, etwa bei Rechts- oder Steuerfragen, kann jede dieser vier Kategorien reale Konsequenzen haben. Ein erfundenes Aktenzeichen sieht überzeugend aus, bis jemand es nachschlägt.
Ursachen: Trainingsdaten, Modellanreize und Inferenzprobleme
Halluzinationen entstehen selten an einer einzigen Stelle. Drei Ursachenblöcke greifen ineinander, und wer nur einen davon adressiert, bekämpft Symptome statt Wurzeln.
Erstens die Trainingsdaten: Veraltete, widersprüchliche oder verzerrte Quellen prägen, was ein Modell für plausibel hält. Zweitens die Anreizstruktur beim Training: Modelle werden meist darauf trainiert, eine Antwort zu liefern, nicht darauf, ehrlich „ich weiß es nicht“ zu sagen. Eine Enthaltung wird selten belohnt, ein plausibel klingender Rateversuch dagegen oft nicht bestraft. Drittens die Inferenzebene, also alles, was während der eigentlichen Generierung passiert, inklusive Retrieval.
Genau hier lohnt eine Unterscheidung, die viele Teams überspringen: Retriever-Fehler gegen Generator-Fehler. Wenn der Retriever falsche oder irrelevante Dokumente liefert, kann selbst das beste Modell nur Unsinn generieren, egal wie gut sein eigentliches Sprachverständnis ist.
Die sogenannte RAG-Triade macht diese Trennung greifbar:
- Context Relevance: Passen die abgerufenen Dokumente überhaupt zur Frage?
- Grounding: Stützt der abgerufene Kontext tatsächlich jede einzelne Behauptung der Antwort?
- Answer Relevance: Beantwortet die generierte Antwort die ursprüngliche Frage überhaupt?
Diese Trennung stammt aus der Architekturdiskussion zu Retrieval-Augmented Generation und zeigt: Ein Großteil der Halluzinationen entsteht bereits vor der eigentlichen Textgenerierung, nämlich beim Abruf der Dokumente. Wer nur am Prompt feilt, während der Retriever mittelmäßige Treffer liefert, wird enttäuscht bleiben.
Wie erkennt man Halluzinationen in der Praxis?
Erkennung beginnt mit einfachen, fast schon banalen Prüfungen und endet bei mehrstufigen Konsistenzchecks. Beide Ebenen brauchen Sie.
Auf der einfachen Ebene lohnen sich:
- Format- und Schema-Checks: Erwartet Ihr System eine bestimmte JSON-Struktur oder ein Datumsformat, prüfen Sie das automatisiert, noch bevor ein Mensch draufschaut.
- Numerische Validierung: Rechenergebnisse, Prozentsätze oder Summen lassen sich oft gegen eine zweite, unabhängige Berechnung abgleichen.
- Quellen-Existenzprüfung: Zitiert das Modell ein Urteil, eine Norm oder eine Studie, prüfen Sie automatisiert, ob diese Quelle in Ihrer Wissensbasis überhaupt existiert.
Auf der komplexeren Ebene setzen Teams zunehmend auf Multi-Model-Consensus, also das Gegenprüfen einer Antwort durch ein zweites, unabhängiges Modell, und auf NLI-gestützte Begründungsprüfung. Ein kleines, fein trainiertes NLI-Modul (Natural Language Inference) prüft dabei automatisiert, ob jede einzelne Behauptung im generierten Text tatsächlich durch die abgerufenen Textstellen gedeckt ist. Das reduziert treue fehlerhafte Ausgaben deutlich, wie Produktionsmuster für RAG-Systeme zeigen.
Für das laufende Monitoring brauchen Sie drei Kennzahlen: die Halluzinationsrate (Anteil ungestützter Aussagen an allen Antworten), die Ablehnungsrate (wie oft das System korrekt „ich weiß es nicht“ sagt) und den Retrieval-Recall (wie viele der relevanten Dokumente tatsächlich gefunden wurden).
Profi-Tipp: Messen Sie Retrieval-Recall und Grounding immer getrennt. Ein System kann exzellente Dokumente finden und trotzdem halluzinieren, wenn die Generierung sie ignoriert. Ohne diese Trennung jagen Sie Symptome, nicht Ursachen.
Prompt Engineering, RAG oder Fine-Tuning: Was wirkt wirklich?
Vier Lösungswege dominieren die Praxis, und keiner davon ersetzt die anderen vollständig.
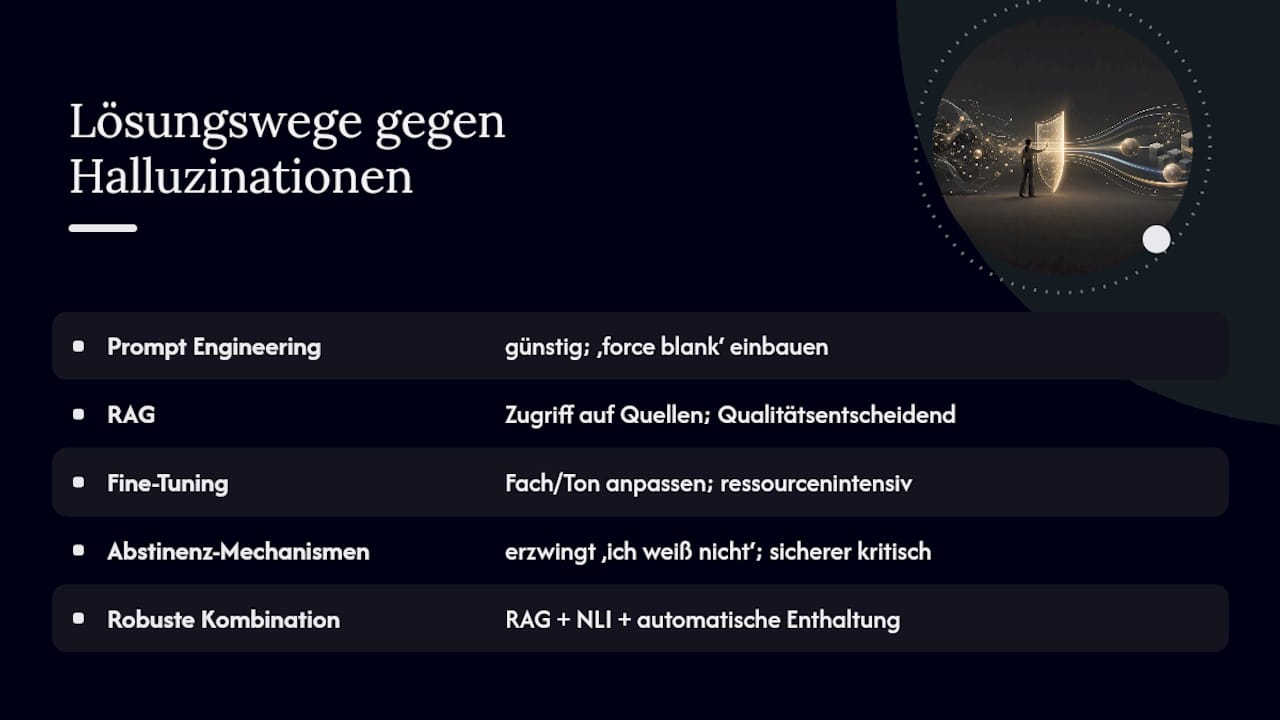
Prompt Engineering ist der günstigste Einstieg. System-Prompts, die explizit vorschreiben, sich nur auf gegebene Quellen zu stützen, senken die Rateneigung merklich. Ein „force blank“-Muster, also die explizite Anweisung, bei Unsicherheit eine leere oder ausweichende Antwort zu geben statt zu spekulieren, gehört in jeden produktiven Prompt. Der Nachteil: Prompt Engineering allein bewirkt beim Faktengehalt wenig, wenn das Modell schlicht keinen Zugriff auf die richtigen Informationen hat.
Retrieval-Augmented Generation greift genau dort an. Es verschafft dem Modell vor der Generierung Zugriff auf verifizierbare Dokumente, wie die Analyse zu AG-Grundig beschreibt. Chunking-Strategie, Reranking und die Wahl der Cutoff-Schwellen entscheiden dabei über die Qualität. Eine schlechte Retrieval-Implementierung mit irrelevanten oder zu langen Textabschnitten macht RAG allerdings wirkungslos, selbst mit dem besten Modell dahinter.
Fine-Tuning und RLHF helfen, ein Modell auf einen Fachbereich oder Tonfall einzustellen. Für die reine Faktentreue bringen sie oft weniger als erwartet und binden erhebliche Ressourcen, weil jedes neue Wissensupdate ein erneutes Training erfordert.
Abstinenz-Mechanismen schließlich sind der am meisten unterschätzte Baustein. Systeme, die aktiv lernen dürfen, „ich weiß es nicht“ zu antworten, schneiden bei kritischen Anwendungen oft besser ab als Systeme, die immer eine Antwort liefern müssen.
Die robusteste Kombination in der Praxis: RAG für den Wissenszugriff, ein NLI-Modul für die Begründungsprüfung, und ein Nachbearbeitungsschritt, der bei fehlender Deckung automatisch zur Enthaltung zwingt. Keine dieser drei Komponenten ersetzt eine der anderen.
Praktische Technikliste: Von Embeddings bis Nachbearbeitung
Die konkrete Umsetzung hängt an ein paar Entscheidungen, die Sie früh treffen sollten, weil sie später teuer zu ändern sind.
-
Embeddings wählen: Größere Umbettung-Modelle liefern bessere Trefferqualität, kosten aber mehr Rechenzeit und Speicher. Für die meisten Kanzlei- oder Fachanwendungen reicht ein mittelgroßes Modell, kombiniert mit sauber geschnittenen Chunks, oft aus. Die Chunk-Größe selbst bestimmt Ihr Token-Budget pro Anfrage, zu große Chunks verwässern die Relevanz, zu kleine Chunks zerreißen den Kontext.
-
HyDE einsetzen: Der HyDE-Ansatz (Hypothese-und-Denis beziehungsweise Hypothese-und-Elbe) generiert zunächst eine hypothetische Antwort und sucht dann nach Dokumenten, die dieser Hypothese ähneln, statt direkt nach der Frage zu suchen. Multi-Query-Varianten, die mehrere Hypothesen parallel erzeugen und deren Embeddings mitteln, glätten Einzelausreißer im Vektorraum, sind laut den Architekturhinweisen zu Nachtdesigns aber auch teurer. Führen Sie das inkrementell ein.
-
Reranking und Cutoffs: Ein zweistufiger Aufbau, bei dem ein schneller Retriever eine grobe Trefferliste liefert und ein Reranker diese anschließend präzisiert, verbessert laut der AWS Prescriptive Guidance zu RAG-Optionen die Präzision deutlich. Legen Sie eine harte Cutoff-Schwelle fest, unterhalb der ein Dokument gar nicht erst in den Kontext wandert.
-
Nachbearbeitung: Jede Ausgabe sollte automatisch Quellen verlinken, Zahlen gegen eine zweite Berechnung prüfen und bei fehlender Deckung einen „No-Answer“-Fallback auslösen, statt eine unsichere Antwort einfach durchzulassen.
Production Hardening: Logging, Monitoring und Feedback
Ein System, das im Test gut aussieht, kann in Produktion trotzdem driften. Ohne Instrumentierung merken Sie das erst, wenn ein Mandant sich beschwert.
Ihr minimales Logging-Set sollte enthalten:
- Die vollständige Nutzeranfrage samt Zeitstempel.
- Die generierte Antwort im Originalwortlaut.
- Die tatsächlich abgerufenen Retriever-Dokumente inklusive ihrer Relevanz-Scores.
- Die verwendeten Modellparameter, etwa Temperatur und Modellversion.
Ohne diese vier Datenpunkte lässt sich ein späterer Fehlerfall kaum rekonstruieren, wie der Leitfaden zum Debugging von LLM-Halluzinationen in Produktion betont. Setzen Sie darauf ein Dashboard, das Halluzinationsrate, Ablehnungsrate und ungewöhnliche Ausschläge in Echtzeit meldet, statt nur wöchentlich Stichproben zu ziehen.
Genauso wichtig: eine Feedback-Schleife mit menschlichen Prüfern (Human-in-the-Loop), die zweifelhafte Antworten markieren, und regelmäßiges Red-Teaming, bei dem gezielt versucht wird, das System zu Fehlern zu provozieren, bevor ein echter Nutzer das tut.
Publisher-Praxis: Warum Nachprüfbarkeit den Unterschied macht
In domänenkritischen Bereichen wie der Steuerberatung reicht technische Sorgfalt allein nicht, die Nachprüfbarkeit jeder Aussage muss zum Standard werden. Arminius-ki verknüpft deshalb jede generierte Antwort mit der konkreten Quelle, dem Gesetzestext, dem BFH-Urteil oder dem BMF-Schreiben, aus dem sie stammt, und hostet die gesamte Verarbeitung ausschließlich in deutschen Rechenzentren.
Eine Aussage ohne Quellenangabe ist in der Steuerberatung keine Antwort, sondern ein Risiko. Erst die Verknüpfung von Mandantendaten mit einer nachvollziehbaren Rechtsquelle macht eine KI-Ausgabe für die Kanzleiarbeit brauchbar.
Human-in-the-Loop bleibt dabei kein Lippenbekenntnis: Die Kanzlei prüft jeden Entwurf, bevor er den Mandanten erreicht, und genau diese Kombination aus Quellenverlinkung und menschlicher Freigabe senkt das Risiko folgenreicher Fehler in kritischen Domänen erheblich.
Kurzperspektive: Wohin entwickelt sich die Praxis?
Die eigentliche Herausforderung ist ein Anreizproblem: Modelle werden für Antworten belohnt, nicht für ehrliche Enthaltung. Solange sich das nicht ändert, bleibt Messbarkeit der wichtigste Hebel. Wer Retrieval-Recall verbessert und Ablehnung aktiv belohnt statt bestraft, baut robustere Systeme als jeder reine Modellwechsel es könnte.
— Florian
Arminius: Nachprüfbare KI-Antworten für Ihre Kanzlei
Es gibt KI-Lösungen für Steuerberatungskanzleien, die Prinzipien wie Quellenverknüpfung, Mensch-in-der-Schleife und Hosting in Deutschland anwenden.
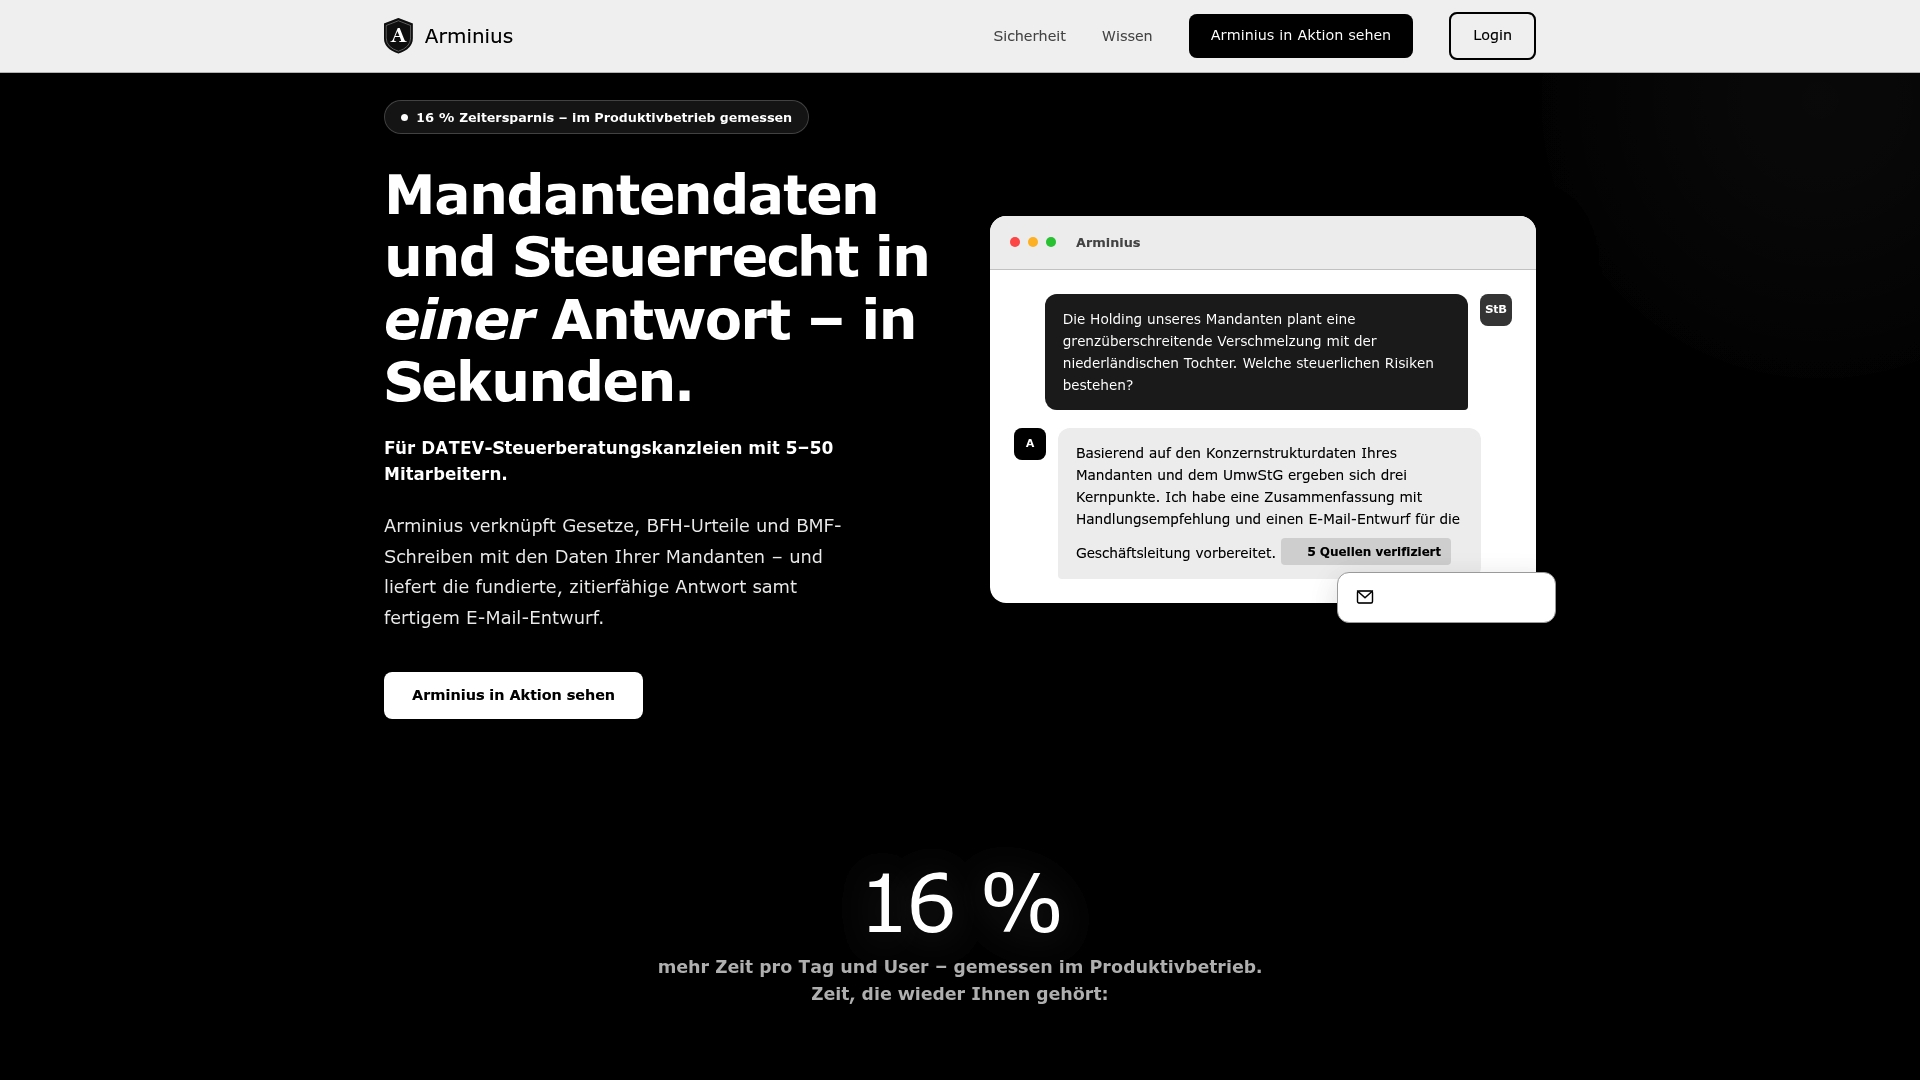
Jede Antwort, die Arminius generiert, ist mit der konkreten Rechtsquelle verlinkt, jede E-Mail-Antwort an Mandanten bleibt vor dem Versand in Ihrer Prüfung. Das System ist vollständig in DATEV-Workflows integriert und läuft ausschließlich auf deutschen Servern, inklusive AVV und §203-Vereinbarung. Wenn Sie prüfen wollen, ob sich der Umstieg für Ihre Kanzlei lohnt, finden Sie die Details zu Modulen und Einrichtung auf der Preisseite von Arminius. Für eine strukturierte Einordnung, worauf es bei der Auswahl einer KI-Lösung für Steuerberater überhaupt ankommt, lohnt sich zusätzlich ein Blick auf die Auswahlkriterien für KI in der Kanzlei.
Quellen
Für die technische Vertiefung lohnen sich:
- Schluss mit Halluzinationen: Wie RAG LLMs wirklich erdet
- Retrieval Augmented Generation: Architektur und Design
- Unite
- Debugging LLM‑Halluzinationen in der Produktion: Ein umfassender Leitfaden
- Retrieval‑Augmented‑Generation Options — AWS Prescriptive Guidance
Diese Auswahl dient als Ausgangspunkt für tiefere Implementierungsrecherche, nicht als vollständige Bibliografie.
Empfehlungen
Häufige Fragen
- Wie kann man KI-Halluzinationen reduzieren?
- Die wirksamste Kombination ist Retrieval-Augmented Generation mit sauberem Chunking, eine NLI-gestützte Begründungsprüfung und ein System-Prompt, der explizite Enthaltung erlaubt. Produktions-Audits zeigen, dass RAG die Halluzinationsrate senkt, aber selbst in guten Implementierungen Restraten zwischen 17 % und 34 % übrig bleiben können, weshalb Monitoring unverzichtbar ist.
- Was kann ich gegen Halluzinationen tun?
- Trennen Sie zunächst Retriever-Fehler von Generator-Fehlern, indem Sie Retrieval-Recall separat messen. Ergänzen Sie danach automatisierte Nachbearbeitung, etwa Quellenverlinkung und numerische Prüfung, sowie ein Logging-System, das Anfrage, Antwort und Retriever-Dokumente speichert, wie der Leitfaden zum Produktions-Debugging empfiehlt.
- Können Halluzinationen wieder verschwinden?
- Vollständig verschwinden Halluzinationen mit heutigen Architekturen nicht, aber ihre Häufigkeit lässt sich durch RAG, Begründungsprüfung und Enthaltungsregeln deutlich senken. Ein System, das aktiv lernt, unsichere Fragen abzulehnen, bleibt in kritischen Anwendungen zuverlässiger als eines, das immer eine Antwort erzwingt.
- Was kostet der Einsatz von Arminius für meine Kanzlei?
- Die aktuellen Preise und der Funktionsumfang der einzelnen Module sind auf der Preisseite von Arminius einsehbar. Dort finden Sie auch Informationen zur einmaligen Einrichtung.
- Reicht Prompt Engineering allein, um Halluzinationen zu vermeiden?
- Nein, Prompt Engineering senkt die Rateneigung, kann aber fehlende Informationen nicht ersetzen. Ohne Retrieval-Augmented Generation oder eine vergleichbare Wissensquelle bleibt das Modell auf sein Trainingswissen beschränkt und halluziniert dort weiter, wo dieses Wissen lückenhaft ist.