PDF Daten extrahieren: Methoden im Praxisvergleich
Daten aus PDFs extrahieren: Praxisvergleich pdfplumber, PyMuPDF, Camelot und Tesseract OCR; bei sensiblen Daten lokal in Deutschland hosten.
Markierbaren Text ziehen Sie per Copy & Paste oder mit pdfplumber und PyMuPDF direkt heraus. Bei Tabellen führt an Camelot oder tabula-py kaum ein Weg vorbei. Gescannte PDFs brauchen zuerst OCR mit Tesseract, erst danach lohnt sich ein Tabellenparser. Für Kanzleien und Unternehmen mit sensiblen Mandantendaten gilt zusätzlich: Cloud-Konverter sind bei personenbezogenen Daten heikel, eine lokale oder in Deutschland gehostete Lösung ist hier fast immer die sicherere Wahl.
Kurz gesagt:
- Für wiederkehrende Tabellen aus PDFs sind automatisierte Skripte mit pdfplumber oder Camelot effizienter als manuelle Methoden.
- Bei sensiblen Mandantendaten empfiehlt sich die lokale Verarbeitung, da Cloud-Konverter Datenschutzrisiken bergen.
- Bei gescannten PDFs ist eine Vorverarbeitung mit OCR-Software wie Tesseract notwendig, um maschinenlesbare Texte zu erhalten.
- Die Qualität der Datenextraktion hängt stark vom Layout, der Dokumentenart und der nachfolgenden Kontrolle ab.
- Eine sorgfältige Auswahl der Tools basierend auf Volumen, Layoutstabilität und Datenschutz ist entscheidend für eine zuverlässige Automatisierung.
Welche Methoden gibt es, um PDF-Daten zu extrahieren?
Wer Daten aus PDF extrahieren will, hat fünf realistische Optionen, und keine davon ist für jeden Fall richtig. Die Wahl hängt vom Dokumenttyp, der Menge und davon ab, ob der Vorgang einmalig oder wiederkehrend ist.
Bei einzelnen Seiten mit wenig Inhalt reicht Copy & Paste aus einem PDF-Betrachter. Schnell, aber fehleranfällig bei Tabellen, weil Spaltenumbrüche oft verrutschen. Desktop-Programme wie Adobe Acrobat Pro bieten eine grafische Oberfläche mit Exportfunktionen für Tabellen und Formulare, ideal für Gelegenheitsnutzer ohne Programmierkenntnisse. Online-Konverter wandeln PDF zu Excel oder Word in Sekunden um, sind aber bei sensiblen Dokumenten aus Datenschutzsicht ein Risiko, da die Datei auf einem fremden Server verarbeitet wird. Python-Bibliotheken wie pdfplumber, PyMuPDF oder Camelot ermöglichen automatisierte, wiederholbare Extraktion in Batch-Verarbeitung, verlangen aber Grundkenntnisse im Programmieren. KI-gestützte Parser schließlich verstehen Dokumentenkontext auch bei wechselnden Layouts und sind damit die robusteste, aber auch komplexeste Option.
- Einmalige Aufgabe, wenig Struktur: Copy & Paste oder Adobe Acrobat Pro
- Wiederkehrende Tabellenextraktion mit festem Layout: pdfplumber oder Camelot per Skript
- Große Mengen, wechselnde Layouts: KI-gestützter Parser oder LLM-basierte Dokumentenanalyse
- Sensible Mandantendaten: lokale Verarbeitung statt Online-Konverter
Für einmalige Aufgaben zahlt sich Automatisierung selten aus. Sobald aber dieselbe Dokumentart regelmäßig anfällt, etwa monatliche Lieferantenrechnungen, amortisiert sich ein Skript oft schon nach wenigen Durchläufen.
Welche Tools eignen sich für PDF Datenextraktion?
Adobe Acrobat Pro exportiert Tabellen direkt nach Excel und erkennt Formularfelder zuverlässig. Für Anwender ohne Entwicklerhintergrund ist das oft der pragmatischste Einstieg, allerdings kostenpflichtig und ohne echte Automatisierungsschnittstelle für große Stapel.
Online-Konverter sind praktisch für einzelne, unkritische Dateien. Bei Mandantendaten oder anderen sensiblen Inhalten sollten Sie sie meiden, weil die Datei den eigenen Server verlässt. Wer regelmäßig mit vertraulichen Unterlagen arbeitet, sollte sich vorher mit den Datenschutzrisiken beim Einsatz von Cloud-KI-Tools auseinandersetzen, die für Online-Konverter im Grunde genauso gelten.
Für PDF Datenverarbeitung in größerem Umfang führt der Weg über Python. Vier Bibliotheken dominieren die Praxis:
- PyPDF2: einfache Text- und Metadatenextraktion, schnell eingerichtet, aber schwach bei komplexen Layouts
- pdfplumber: die erste Wahl für Tabellen, da es Spalten- und Zeilenkoordinaten sauber erkennt
- PyMuPDF: bei Stapelverarbeitung das schnellste der vier, besonders bei hohem Volumen relevant
- Camelot / tabula-py: spezialisiert auf strukturierte Tabellen mit klaren Linien oder Whitespace-Mustern
Open-Source-Benchmarks zeigen, dass Bibliotheken wie pypdfium2, pypdf und PyMuPDF bei nicht gescannten PDFs häufig eine Extraktionsqualität von 95 bis 97 % erreichen. Das gilt allerdings nur für textbasierte Dokumente. Sobald ein PDF eingescannt wurde, versagen alle vier Bibliotheken, weil kein maschinenlesbarer Text vorliegt. Dann braucht es zusätzlich OCR-Software wie pytesseract, bevor überhaupt etwas extrahiert werden kann.
Wie extrahiert man Tabellen Schritt für Schritt?
Der Ablauf für Tabellen aus PDF zu Excel folgt in der Praxis immer demselben Muster, egal ob es sich um zehn oder zehntausend Dokumente handelt.
- Dokumenttyp prüfen: Text markieren und kopieren, wenn das gelingt, liegt echter Text vor, wenn nicht, ist es ein Scan.
- Tabellen extrahieren: Bei textbasierten PDFs
extract_tables()aus pdfplumber aufrufen und das Ergebnis direkt in einen Pandas-DataFrame laden. - Bereinigen: Kopfzeilen vereinheitlichen, falsch erkannte Spalten zusammenführen, Sonderzeichen und Zeilenumbrüche innerhalb von Zellen entfernen.
- Bei Scans: Seiten mit PyMuPDF als Bild rendern, mit Tesseract OCR auslesen, anschließend Camelot oder tabula-py auf das Ergebnis anwenden.
- Exportieren: Als CSV, JSON oder XLSX speichern, je nachdem, welches System die Daten weiterverarbeitet.
Ein Whitepaper zur Inhaltsextraktion aus PDF-Dokumenten empfiehlt für Camelot konkrete Accuracy- und Whitespace-Parameter, um fehlerhafte Extrakte automatisch auszusortieren.
Profi-Tipp: Bauen Sie bei Batch-Verarbeitung immer ein Logging pro Datei ein. Wenn eine von hundert Rechnungen eine abweichende Spaltenzahl hat, wollen Sie das in der Konsole sehen, nicht erst im fertigen Excel-Export bemerken.
Wann braucht man OCR für gescannte PDFs?
Ein eingescanntes PDF ist im Grunde ein Foto, kein Dokument. Ohne optische Zeichenerkennung gibt es keinen Text zum Extrahieren, egal welche Bibliothek Sie einsetzen. Genau hier liegt der Unterschied zwischen textbasierten und bildbasierten PDFs, der in der Praxis am meisten Verwirrung stiftet: Ein PDF kann aussehen wie normaler Text und trotzdem nur ein Bild sein.
Vor der eigentlichen Erkennung entscheidet die Vorverarbeitung über die Qualität des Ergebnisses:
- Auflösung auf mindestens 300 dpi anheben, niedrigere Werte produzieren deutlich mehr Erkennungsfehler
- Schräg eingescannte Seiten geraderichten (Deskewing)
- Kontrast erhöhen, besonders bei alten oder schlecht gescannten Dokumenten
- Die richtige Spracheinstellung in Tesseract setzen, sonst verwechselt die Engine Umlaute und Sonderzeichen
Tesseract läuft lokal, kostet nichts und eignet sich gut für sensible Dokumente, weil nichts das eigene System verlässt. Cloud-OCR-Dienste skalieren dafür besser bei sehr großen Mengen, verlagern aber die Datei auf fremde Server. Wer beides zusammenbringen will, nutzt die Konfidenzwerte, die Tesseract pro Wort ausgibt, und leitet Ergebnisse unter einem Schwellenwert automatisch an eine manuelle Prüfung weiter.
Wie wählt man Methode und Werkzeug für Automatisierung?
Die Entscheidung hängt an vier Kriterien: Volumen, Layoutvariabilität, Datenschutzanforderung und wie tief die Extraktion in bestehende Systeme integriert werden muss.
- Wenige Dokumente mit festem Layout: ein Skript mit pdfplumber oder Camelot reicht völlig aus
- Hohes Volumen mit festem Layout: PyMuPDF für die Geschwindigkeit, ergänzt durch Camelot für die Tabellenlogik
- Wechselnde Layouts, viele verschiedene Absender: klassische Template-Ansätze brechen hier regelmäßig, ein KI-gestützter Parser wie sie IDP-Lösungen bieten interpretiert Kontext statt starrer Positionen
- Sensible Mandanten- oder Personaldaten: lokale Verarbeitung oder eine in Deutschland gehostete Lösung statt Cloud-Dienst
Template-basierte Systeme sind günstig und schnell eingerichtet, solange sich das Layout nie ändert. Sobald ein Lieferant seine Rechnungsvorlage umstellt, bricht die Extraktion, und jemand muss das Template händisch nachziehen. KI-gestützte Ansätze, wie sie auch bei der Integration von KI in DATEV-Workflows eine Rolle spielen, sind hier robuster, weil sie Felder anhand von Bedeutung statt fester Position erkennen.
Profi-Tipp: Führen Sie für jede automatisierte Extraktion ein Konfidenz-Feld mit. Alles unter 90 % geht automatisch in eine manuelle Prüfschleife, nicht direkt in die Buchhaltung.
Wie vermeidet man typische Fehler bei der Extraktion?
Die meisten Probleme entstehen nicht bei der Extraktion selbst, sondern danach, wenn niemand die Ausgabe kontrolliert.
- Zeichenkodierung sofort auf UTF-8 normalisieren, sonst zerfallen Umlaute in Sonderzeichen-Ketten
- Datumsformate früh vereinheitlichen, bevor unterschiedliche Schreibweisen die Auswertung verzerren
- Ein Testset aus mehreren Lieferanten und Layouts anlegen, nicht nur aus dem einen Musterdokument, das gerade vorlag
- Regelbasierte Prüfungen einbauen, etwa ob Summenspalten tatsächlich aufgehen oder Pflichtfelder leer geblieben sind
Profi-Tipp: Ein Testset mit nur einer Rechnungsvorlage sagt nichts über die Praxis aus. Sammeln Sie mindestens fünf unterschiedliche Layouts, bevor Sie ein Skript produktiv einsetzen.
Was bedeutet das für Steuerkanzleien mit sensiblen Mandantendaten?
Kanzleien, die Mandantendokumente automatisiert auslesen, stehen vor einer zusätzlichen Hürde: Die Lösung muss nicht nur genau sein, sondern auch datenschutzkonform bleiben. Eine in Deutschland gehostete Verarbeitung ist hier oft der entscheidende Faktor, gerade wenn Steuerbescheide oder Jahresabschlüsse betroffen sind. Arminius verbindet automatisierte Dokumentenauswertung mit der Auswahl geeigneter KI-Kriterien für Steuerberater und hält die Verarbeitung dabei innerhalb deutscher Rechenzentren.
Wo finden Sie weiterführende Informationen?
Wer tiefer in die technische Umsetzung einsteigen will, findet in den py-pdf Benchmarks konkrete Leistungsvergleiche und im Service-Meister Whitepaper Details zu Tabellenparametern und Strukturerkennung.
Was die meisten Anleitungen zur PDF-Extraktion falsch machen
Die meisten Ratgeber zu diesem Thema tun so, als gäbe es die eine richtige Bibliothek. Gibt es nicht. Die eigentliche Entscheidung liegt vorher: Wie viele Dokumente, wie stabil ist das Layout, wie kritisch sind die Daten. Wer das überspringt und direkt zu Camelot oder einem KI-Parser greift, baut oft eine Lösung, die für sein tatsächliches Problem überdimensioniert oder unterdimensioniert ist.
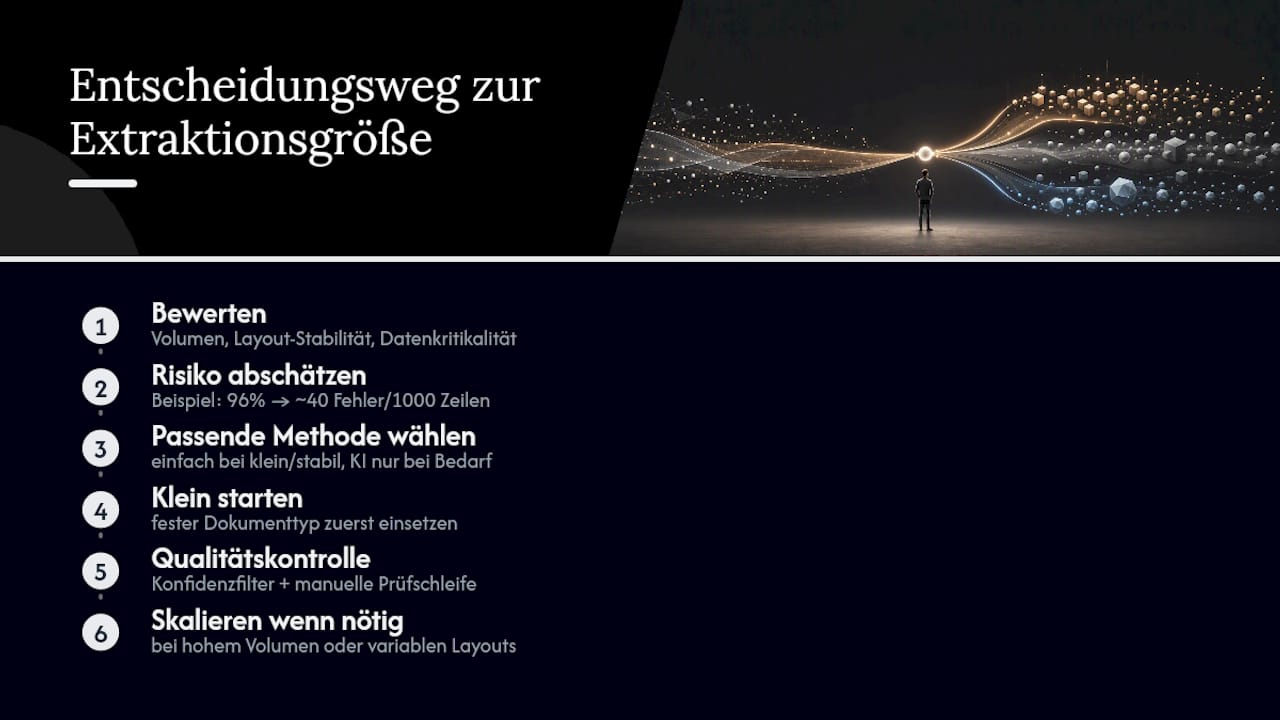
Was ich in der Praxis unterschätzt sehe: die Qualitätskontrolle nach der Extraktion. Ein Skript, das Tabellen mit 96 % Genauigkeit ausliest, klingt beeindruckend, bedeutet aber bei tausend Dokumenten immer noch vierzig fehlerhafte Zeilen. Ohne Konfidenzfilter und manuelle Prüfschleife landen diese Fehler unbemerkt in der Buchhaltung. Genau das unterscheidet eine Bastellösung von einem Prozess, der in einer Kanzlei tatsächlich Vertrauen verdient.
Meine Empfehlung für Automatisierungsprojekte: klein anfangen, mit einem festen Dokumenttyp, und erst dann auf variable Layouts oder KI-gestützte Parser umsteigen, wenn das Volumen es rechtfertigt. Die Verlockung, sofort die komplexeste Lösung zu bauen, führt öfter zu Wartungsaufwand als zu Zeitersparnis.
— Florian
Quellen
- py‑pdf Benchmarks
- Inhaltsextraktion und Logische Strukturerkennung in PDF‑Dokumenten (Service‑Meister Whitepaper)
Empfehlungen
Häufige Fragen
- Was bedeutet PDF-Dateien extrahieren?
- Es bezeichnet den Vorgang, Text, Tabellen oder Metadaten aus einer PDF-Datei in ein maschinenlesbares Format wie CSV, JSON oder Excel zu überführen, statt die Daten manuell abzutippen.
- Wie kann ich aus einer PDF-Datei etwas herauskopieren?
- Bei textbasierten PDFs reicht Markieren und Kopieren im PDF-Betrachter oder ein Export über Adobe Acrobat Pro. Bei Tabellen liefert das oft verrutschte Spalten, dann lohnt sich pdfplumber oder Camelot per Skript.
- Kann ChatGPT PDFs auslesen?
- ChatGPT kann Text aus hochgeladenen PDFs auslesen und zusammenfassen, allerdings verlässt die Datei dabei den eigenen Server. Bei Mandanten- oder Personaldaten ist das aus Datenschutzsicht riskant, und eine lokal gehostete Lösung ist vorzuziehen.
- Wie kann ich Daten aus einem PDF-Dokument automatisch auslesen?
- Für regelmäßig wiederkehrende Dokumente eignet sich ein Python-Skript mit pdfplumber oder PyMuPDF für Text und Camelot oder tabula-py für Tabellen. Bei gescannten PDFs muss zuerst Tesseract als OCR-Vorstufe laufen, bevor die Tabellenerkennung greift.