Datenpipeline für die Steuerkanzlei: So läuft die Automatisierung
Eine Datenpipeline in Ihrer Steuerkanzlei überträgt Mandantendaten automatisch nach DATEV, reduziert Nacharbeit und ist konform mit der DSGVO.
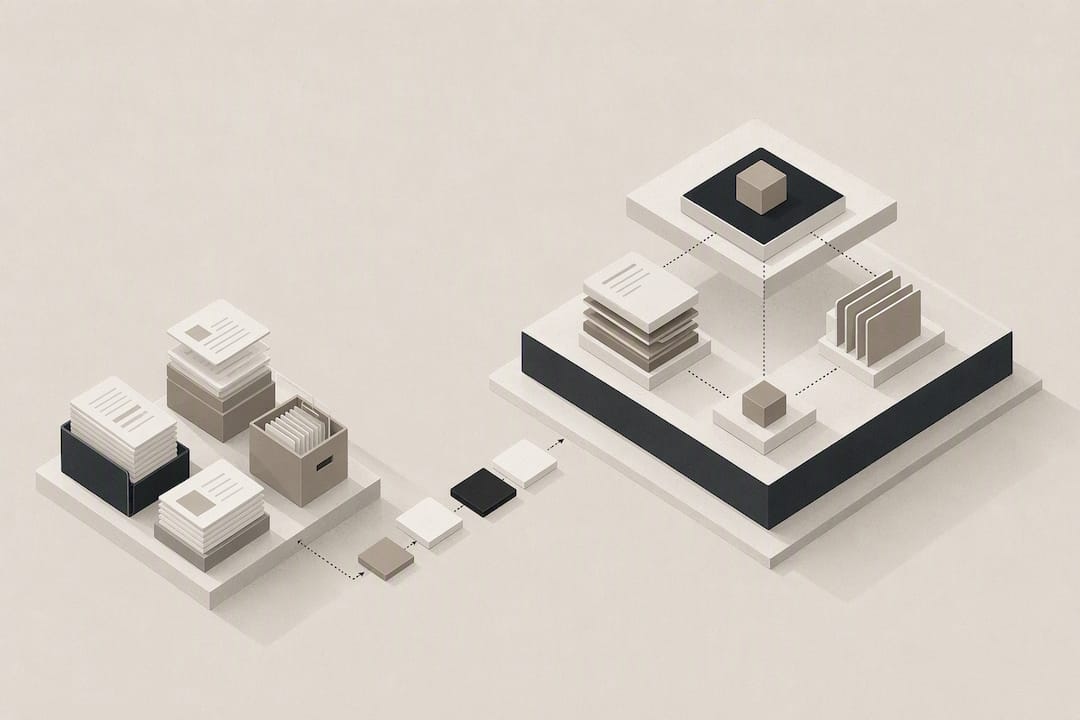
Eine Datenpipeline für Ihre Steuerkanzlei ist eine automatisierte Route, die Mandantendaten zuverlässig von Vorsystemen in DATEV und in einen kanzleiinternen Datenraum überführt. Der Kernnutzen liegt in weniger manuellen Korrekturschritten und mehr Zeit für die eigentliche Beratung. Wichtig dabei: DATEV bleibt die zentrale Zielinstanz, während Hosting und Datenverarbeitung DSGVO-konform in Deutschland stattfinden sollten.
Kurz gesagt:
- Eine Datenpipeline reduziert manuellen Aufwand, indem sie Mandantendaten automatisch aus Vorsystemen in DATEV überführt, was die Beratungstätigkeit optimiert.
- Für die Umsetzung sind Quellen wie Buchhaltung, Bankfeeds und Lohnsysteme relevant, wobei Formate wie DATEV-CSV und XML früh vereinheitlicht werden sollten.
- Unterschiedliche Pipeline-Typen (Batch, Streaming, CDC) passen je nach Anwendungsfall, wobei Batch-Prozesse für Mandanten-Onboarding meist am schnellsten einsatzfähig sind.
- Die Integration in DATEV erfolgt über standardisierte Formate, Belegtransfer und DATEVconnect, wobei auf korrekte Mandanten- und Kontenverwaltung zu achten ist.
- Ein Pilotprojekt lässt sich in etwa 90 Tagen umsetzen, wobei eine klare Verantwortlichkeit, Schulung und Überwachung entscheidend für den Erfolg sind.
Was ist eine Datenpipeline und warum betrifft sie Ihre Kanzlei
Eine Datenpipeline ist eine festgelegte Abfolge: Daten kommen aus einer Quelle, werden verarbeitet und landen an einem definierten Ziel. Genau diese drei Schritte, Quelle, Verarbeitung, Ziel, entscheiden darüber, ob Mandantendaten am Ende sauber in DATEV liegen oder ob jemand in der Kanzlei sie mühsam von Hand nachbearbeiten muss.
In der Praxis besteht eine Pipeline aus vier Komponenten:
- Datenquelle: Das System, aus dem die Rohdaten stammen, etwa ein Buchhaltungstool, ein Dokumentenmanagementsystem oder die Bank-Schnittstelle eines Mandanten.
- Aufnahme (Ingest): Der Moment, in dem Daten in die Pipeline eintreten, sei es per Datei-Upload, API-Abruf oder E-Mail-Anhang.
- Verarbeitung: Hier werden Formate angeglichen, Werte geprüft und Felder auf die Zielstruktur gemappt.
- Ziel: Meist DATEV selbst oder ein kanzleiinterner Datenraum, aus dem weitere Auswertungen gespeist werden.
Für den Kanzleialltag heißt das ganz konkret: Ein Beleg, den ein Mandant fotografiert, durchläuft im Idealfall automatisch OCR-Erkennung, Kontenzuordnung und Übergabe an die Finanzbuchhaltung, ohne dass jemand in der Kanzlei die Zahlen erneut abtippt. Dasselbe Prinzip gilt für Lohndaten, Fristensynchronisation und Mandantenkommunikation. Wer diesen Ablauf einmal sauber aufgesetzt hat, verschiebt Arbeitszeit von der Dateneingabe hin zur fachlichen Prüfung, also genau dorthin, wo eine Steuerfachkraft ihren Wert wirklich stiftet.
Architektur: Welche Komponenten und Tools eine Kanzlei braucht
Die Architektur einer Datenpipeline in der Steuerkanzlei folgt einem klaren Muster, auch wenn die konkrete Werkzeugwahl variiert.
- Datenquellen benennen: Buchhaltungstools der Mandanten, das eigene Dokumentenmanagementsystem, Bankfeeds und Lohnprogramme sind die häufigsten Ausgangspunkte. Jede Quelle liefert ein eigenes Format und einen eigenen Rhythmus, ein Grund, warum Pipelines selten pauschal funktionieren.
- Aufnahme und Formathandling: DATEV-CSV und XML sind die gängigen Austauschformate, ergänzt durch API-Zugriffe, wo verfügbar. Wer diese Formate früh in der Pipeline vereinheitlicht, spart sich später doppelte Mapping-Arbeit.
- Transformationsschicht: Hier passiert die eigentliche Wertschöpfung. OCR extrahiert Text aus Belegen, Validierungsregeln prüfen Plausibilität, Mapping-Logik ordnet Werte den richtigen DATEV-Feldern zu, und Enrichment reichert Datensätze etwa mit Fristen oder rechtlichem Kontext an.
- Speicherentscheidung: Manche Kanzleien arbeiten rein DATEV-zentriert, andere bauen einen zusätzlichen, kanzleiinternen Datenraum auf. Eine eigene semantische Schicht mit Taxonomie und Kennzahlen macht Mandantendaten zu proprietärem Wissen der Kanzlei statt zu reinen Plattformdaten, was die Abhängigkeit von einzelnen Anbietern reduziert.
- Orchestrierung und Monitoring: Workflow-Tools wie n8n verbinden die einzelnen Schritte, lösen bei Fehlern Benachrichtigungen aus und protokollieren jeden Durchlauf. Ohne Monitoring merkt niemand, wenn eine Pipeline mitten in der Nacht stillsteht, und genau das ist der Moment, in dem Fristen reißen.
Trotz fehlender offener REST-Schnittstelle bei DATEV lassen sich Integrationen über standardisierte Formate und Middleware wie n8n realisieren, die DATEVconnect und den Belegtransfer mit externen Systemen verknüpfen.
Batch, Streaming oder CDC: Welcher Pipeline-Typ passt wohin?
Nicht jeder Prozess in der Kanzlei braucht dieselbe technische Lösung. Drei Grundmuster decken fast alle Fälle ab:
- Batch: Daten werden in festen Intervallen verarbeitet, etwa einmal täglich oder wöchentlich. Passt zu Lohnläufen und monatlichen Buchungsexporten.
- Streaming: Daten fließen kontinuierlich und werden nahezu in Echtzeit verarbeitet. Sinnvoll bei Belegerfassung per App, wenn Mandanten sofort eine Bestätigung erwarten.
- CDC (Change Data Capture): Nur Änderungen werden erfasst und weitergegeben, nicht der komplette Datenbestand. Praktisch für Stammdatenabgleiche, bei denen sich nur einzelne Felder ändern.
Konkret in der Kanzlei sieht das so aus: Beleg-OCR läuft meist als Streaming-Prozess, weil Mandanten schnelles Feedback erwarten. Mandanten-Onboarding funktioniert gut als Batch, da es sich um einmalige, umfangreiche Datensätze handelt. Fristen-Synchronisation profitiert von CDC, weil nur geänderte Termine relevant sind. Der Lohn-Datenfluss läuft klassisch als Batch, orientiert am monatlichen Abrechnungszyklus.
Profi-Tipp: Beginnen Sie nicht mit dem technisch anspruchsvollsten Fall. Ein Batch-Prozess für Mandanten-Onboarding lässt sich in wenigen Wochen aufsetzen und liefert schneller sichtbaren Nutzen als ein Streaming-System für Echtzeit-Belegerfassung.
Die Entscheidung zwischen den drei Typen ist letztlich eine Abwägung zwischen Aufwand und Nutzen: Streaming ist technisch aufwendiger, aber näher am Mandantenerlebnis. Batch ist einfacher zu warten, aber weniger reaktionsschnell.
DATEV-Integration praktisch: Formate, Schnittstellen, Berechtigungen
DATEV bleibt für die meisten Kanzleien das zentrale Zielsystem, und die Integration läuft über wenige, aber klar definierte Kanäle. Das DATEV-CSV-Format eignet sich für einfache, regelmäßige Datenübertragungen. Der Belegtransfer bringt Dokumente direkt in die Finanzbuchhaltung. DATEVconnect erlaubt eine tiefere, programmatische Anbindung externer Systeme an DATEV-Prozesse. Für einfache Mandate reicht oft die klassische CSV-Schnittstelle, während sich für skalierte Prozesse DATEVconnect oder programmatische Anbindungen eher lohnen, allerdings mit entsprechendem Freischaltungsaufwand.
Bevor eine Pipeline produktiv geht, braucht es einige organisatorische Grundlagen:
- Beraternummer und Mandantennummer müssen korrekt hinterlegt sein, sonst scheitert die Zuordnung schon beim ersten Datensatz.
- Ein gültiger Mandantenvertrag mit Datenübertragungs-Vereinbarung schafft die rechtliche Basis für den automatisierten Austausch.
- Authentifizierung läuft meist über SmartCard oder Token, wobei Berechtigungen so granular vergeben werden sollten, dass nicht jeder Mitarbeiter Zugriff auf alle Mandate hat.
Häufigster Praxisfehler: Mapping-Fehler entstehen fast immer dort, wo Kontenrahmen zwischen Vorsystem und DATEV nicht exakt übereinstimmen. Eine feste Validierungsregel vor dem Import, die abweichende Kontonummern blockiert statt sie automatisch zu übernehmen, verhindert die meisten Folgefehler. Mehr zur technischen Anbindung finden Sie im Überblick zur DATEVconnect-Schnittstelle.
Umsetzungs-Roadmap: 90 Tage vom Pilot zur Produktion
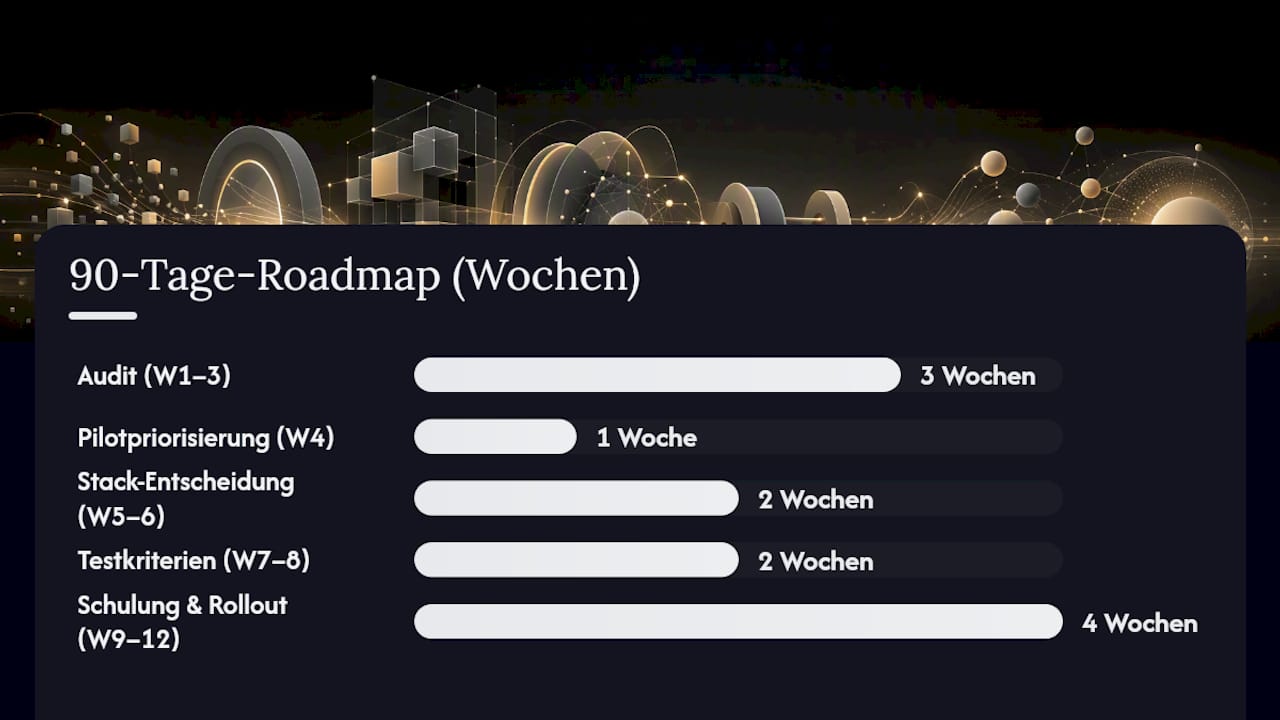
Eine Datenpipeline entsteht nicht über Nacht, aber ein 90-Tage-Zeitraum reicht in der Praxis meist aus, um von der Idee zu einem funktionierenden Piloten zu kommen.
- Audit (Woche 1 bis 3): Bestandsaufnahme aller Datenquellen, Prüfung der Stammdatenqualität und Klärung, wer im Team für welchen Datentyp verantwortlich ist.
- Pilotpriorisierung (Woche 4): Beginnen Sie mit Mandanten-Onboarding, dann Belegerfassung, dann Fristen-Synchronisation, zuletzt Kommunikationsprozesse. Diese Reihenfolge liefert früh sichtbaren Nutzen bei überschaubarem Risiko.
- Stack-Entscheidung (Woche 5 bis 6): Ein Orchestrator wie n8n, idealerweise self-hosted für sensible Mandantendaten, kombiniert mit einer OCR-Lösung für Belege und einem Monitoring-Tool für Fehlerbenachrichtigungen.
- Testkriterien definieren (Woche 7 bis 8): Prüfen Sie Idempotenz (mehrfaches Ausführen ohne Doppelbuchung), Rückrollbarkeit bei Fehlern, klare SLAs und lückenloses Logging.
- Schulung und Rollout (Woche 9 bis 12): Mitarbeiter brauchen Zeit, sich mit dem neuen Ablauf vertraut zu machen. Ein fester Verantwortlicher pro Prozess verhindert, dass Fehler unbemerkt bleiben.
Praxisdaten aus Pilotprojekten zeigen, dass ein Self-Hosted-Orchestrator wie n8n mit vier bis acht Wochen Pilotzeit und überschaubaren Investitionskosten schnell messbare Zeitgewinne erzeugt.
Profi-Tipp: Planen Sie für Schulung und Change-Management mindestens so viel Zeit ein wie für die technische Umsetzung selbst. Eine Pipeline, die niemand versteht, wird im Alltag umgangen statt genutzt.
Datenqualität und Stammdatenpflege: Die häufigste Fehlerquelle
Die technisch ausgefeilteste Pipeline scheitert an schlechten Stammdaten. Unvollständige oder inkonsistente Mandanten- und Kontodaten führen zu manuellen Korrekturschritten, die genau das Effizienzpotenzial zunichtemachen, das eine Datenpipeline eigentlich bringen soll.
Technisch lässt sich dem mit drei Maßnahmen begegnen:
- Schema-Validierung direkt beim Import, die fehlerhafte Datensätze blockiert statt sie durchzuwinken.
- Reconciliation-Läufe, die Quell- und Zielsystem regelmäßig automatisch abgleichen.
- Alerting, das eine Nachricht auslöst, sobald Abweichungen einen definierten Schwellenwert überschreiten.
Organisatorisch braucht es eine feste Taxonomie für Mandantendaten, einen benannten Daten-Owner pro Mandat und regelmäßige Reviews, etwa quartalsweise. Als Kennzahlen eignen sich die Fehlerquote pro Import, die durchschnittliche manuelle Nachbearbeitungszeit und die Pipeline-Latenz zwischen Eingang und Verbuchung. Wer diese drei Werte über einige Monate misst, sieht sehr schnell, wo die Pipeline tatsächlich Zeit spart und wo noch nachgebessert werden muss.
Praxisbeispiel: Wie Arminius Mandantendaten mit Rechtssubstanz verknüpft
Arminius orchestriert genau diese Kette in der Praxis: DATEV-Anbindung, semantische Anreicherung der Mandantendaten und KI-gestützte Antworten auf steuerliche Fachfragen, ergänzt um automatisch generierte E-Mail-Entwürfe für die Mandantenkommunikation. Kanzleien, die diesen Ansatz nutzen, sparen laut Herstellerangabe bis zu 16 % Zeit pro Tag, weil Routinearbeit wegfällt und mehr Kapazität für Beratung bleibt. Gehostet wird die Plattform in deutschen Rechenzentren, datenschutzkonform nach DSGVO.
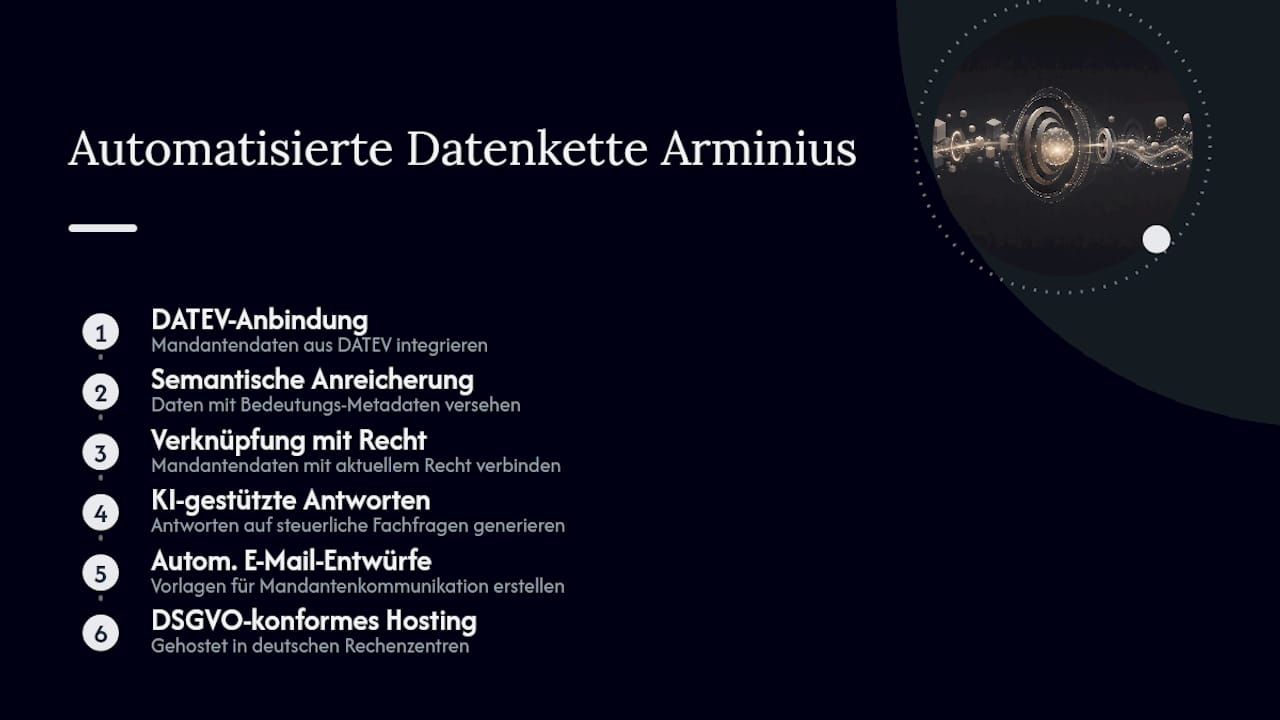
Für eigene Implementierungen lässt sich daraus ableiten: Die Kombination aus sauberer DATEV-Anbindung und einer zusätzlichen semantischen Schicht, die Mandantendaten mit aktuellem Recht verknüpft, liefert mehr Nutzen als eine reine Datenübertragung ohne inhaltliche Anreicherung.
Meine Einschätzung: Klein anfangen, Verantwortung behalten
Die meisten Kanzleien überschätzen den nötigen Umfang für den ersten Schritt. Ein kleines Pilotprojekt, sauber gemessen, schlägt jedes große Reengineering-Vorhaben, das nach einem Jahr noch nicht produktiv ist. Gleichzeitig unterschätzen viele das Risiko von KI-Halluzinationen: Ein Human-in-the-Loop-Prozess ist keine Option, sondern Pflicht, wenn KI-Systeme Mandantendaten verarbeiten. Wer beides beherzigt, macht die eigene Kanzlei nicht nur schneller, sondern strategisch unabhängiger von einzelnen Softwareanbietern.
— Florian
So kann Arminius den Einstieg erleichtern
Es gibt Alternativen zum manuellen Datenabgleich zwischen Vorsystemen und DATEV, die speziell für Kanzleien entwickelt wurden, die keine eigene IT-Abteilung für Pipeline-Wartung aufbauen wollen. Solche Plattformen verknüpfen Mandantendaten automatisch mit aktuellen Gesetzen, BFH-Urteilen und BMF-Schreiben und erstellen daraus fachlich fundierte Antworten sowie fertige E-Mail-Entwürfe.
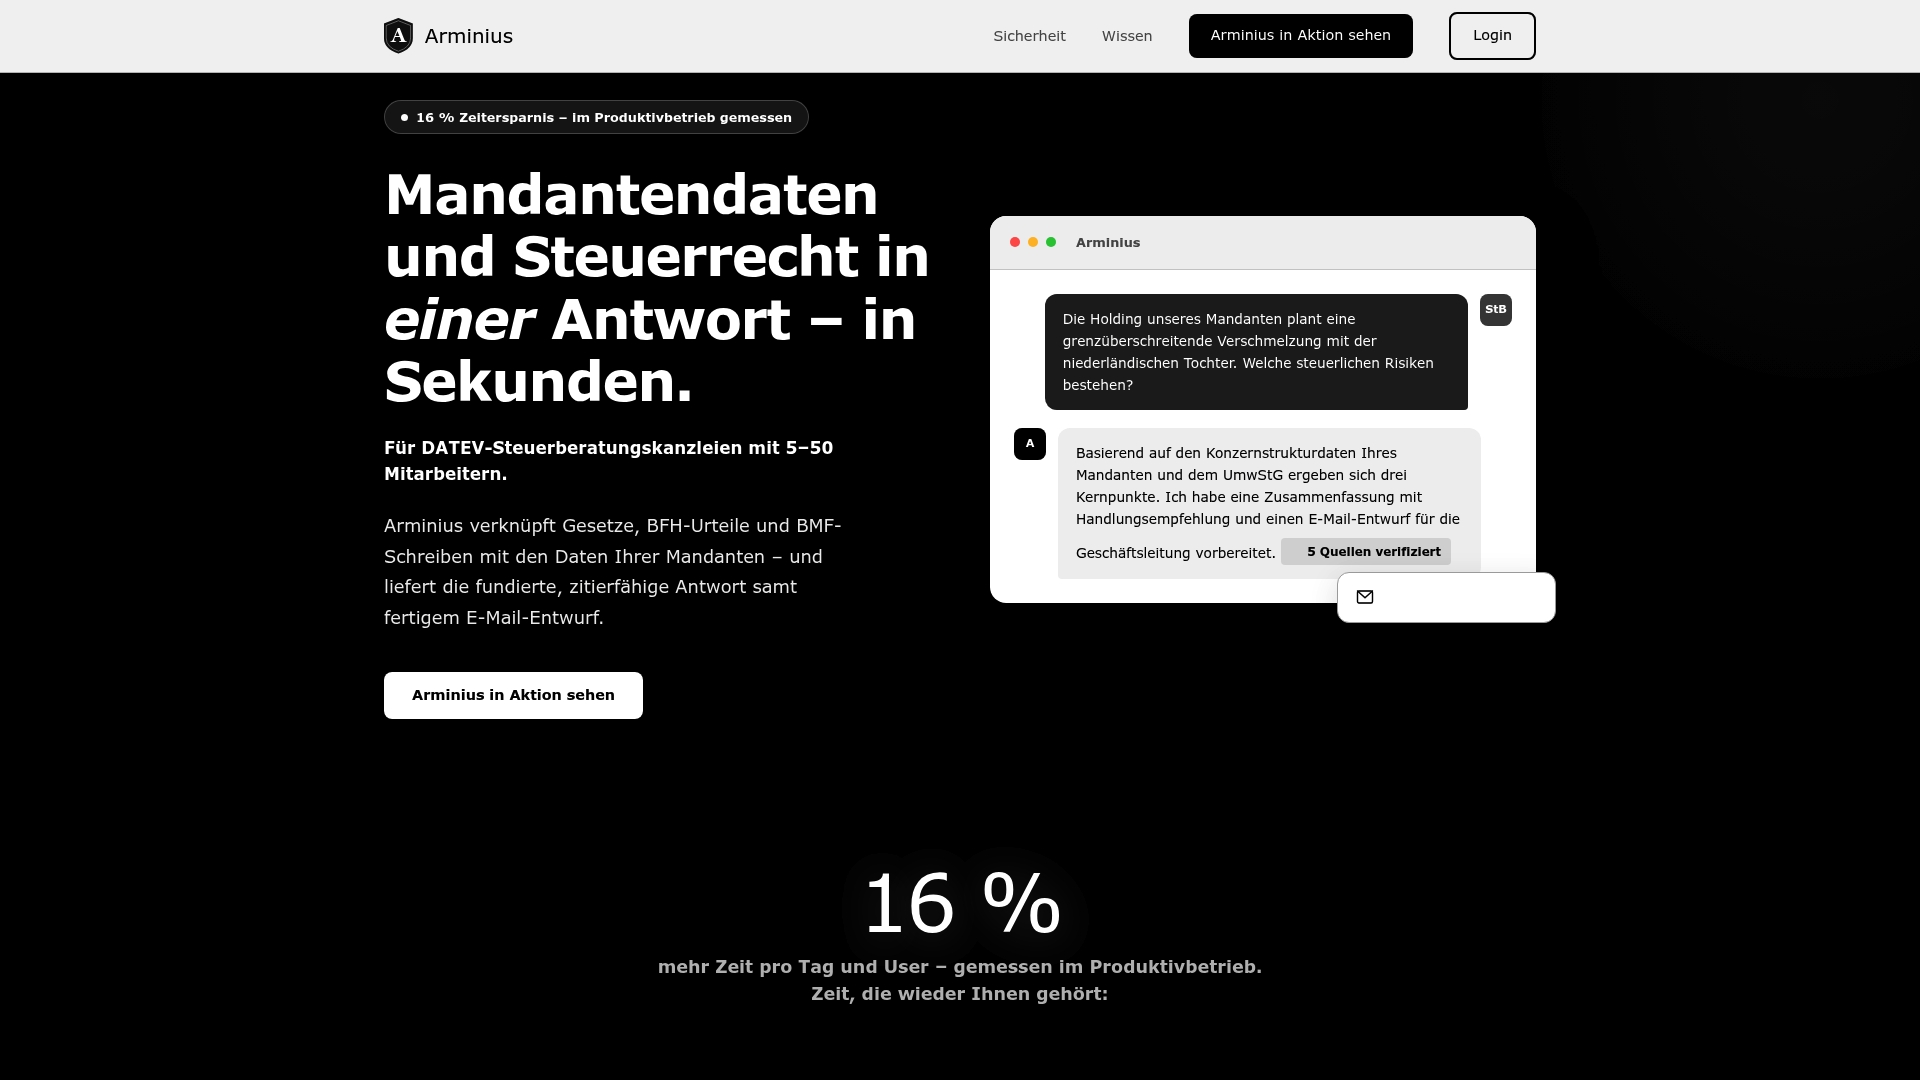
Typische Probleme wie inkonsistente Stammdaten, langsame Reaktionszeiten auf Mandantenanfragen oder das Fehlen proaktiver Hinweise auf Beratungsanlässe adressiert die Plattform direkt in der DATEV-Umgebung, gehostet in deutschen Rechenzentren nach DSGVO-Standard. Wer prüfen möchte, ob der Ansatz zur eigenen Kanzlei passt, findet im vollständigen Leitfaden zu KI in der Steuerberatung eine gute Grundlage für die erste Entscheidung, und kann darüber auch eine Demo anfragen.
Quellen
Wer tiefer einsteigen möchte, findet bei der Bundessteuerberaterkammer konkrete Leitlinien zum KI-Einsatz in Kanzleien sowie praxisnahe Umsetzungsbeispiele bei SzopaLabs zur Digitalisierung von Buchhaltungsdokumenten.
- Datenpipelines: Kosten, Ausfälle, geringer ROI (BigData Insider)
- DATEV API Integration Guide (Apideck)
- Automatisierung Steuerberater: 5 Workflows + Pilot (Fullstack Factory)
Empfehlungen
Häufige Fragen
- Was ist eine Datenpipeline?
- Eine Datenpipeline ist eine automatisierte Abfolge, die Daten aus einer Quelle aufnimmt, verarbeitet und an ein Zielsystem übergibt, in der Steuerkanzlei meist von einem Vorsystem in DATEV.
- Braucht jede Kanzlei eine eigene Datenpipeline?
- Nicht zwingend jede Kanzlei braucht eine vollständige, individuelle Pipeline, doch Kanzleien mit vielen wiederkehrenden Datenübertragungen, etwa Beleg- oder Lohnverarbeitung, sparen durch Automatisierung spürbar Zeit.
- Welches Format nutzt DATEV für den Datenaustausch?
- DATEV-CSV und XML sind die gängigen Austauschformate, ergänzt durch DATEVconnect und den Belegtransfer für tiefere Integrationen.
- Ist n8n für Steuerkanzleien geeignet?
- Ja, n8n eignet sich als Self-Hosted Orchestrator besonders für Kanzleien mit sensiblen Mandantendaten, da Pilotprojekte oft schon nach vier bis acht Wochen messbare Ergebnisse zeigen.
- Wie geht Arminius mit Datenschutz um?
- Arminius verarbeitet Mandantendaten datenschutzkonform in deutschen Rechenzentren und verknüpft sie mit aktuellen rechtlichen Informationen, ohne die fachliche Prüfung durch die Steuerfachkraft zu ersetzen.